我不写代码了,让 GPT 当架构师,Gemini 做 UI,GLM 当程序员 🚀
我不写代码了,让 GPT 当架构师,Gemini 做 UI,GLM 当程序员 🚀
SEAlencehe前言 🚀
为了体验不同的前沿 AI,我手里订阅 薅羊毛 了三个不同的 AI Plan:GPT、Gemini 和 GLM。
在平时做 WebGIS 或前端需求开发时,我越来越明显地感觉到这三个模型各有各的脾气和擅长方向(个人感受:GPT 更能听懂人话、擅长全局规划和挑刺,Gemini 写前端页面和样式审美在线,而 GLM 只要把步骤和边界讲清楚,写业务逻辑相当实在)。
但这也带来了一个很蠢的痛点:每次我先 Push 某一个 AI,写到一半发现它搞不定,就得手动把上下文复制出来,切到另一个 AI 继续 Push。原本是为了提效,结果我自己倒成了最累的“人工调度员”,来回切换反而拖慢了开发节奏。
随着项目任务越来越复杂,我发现指望一个模型从“需求分析”一路包办到“代码验收”,往往不太现实。原因其实并不神秘:
💡 规划、UI、编码和验收,本来就是四种完全不同的工作。
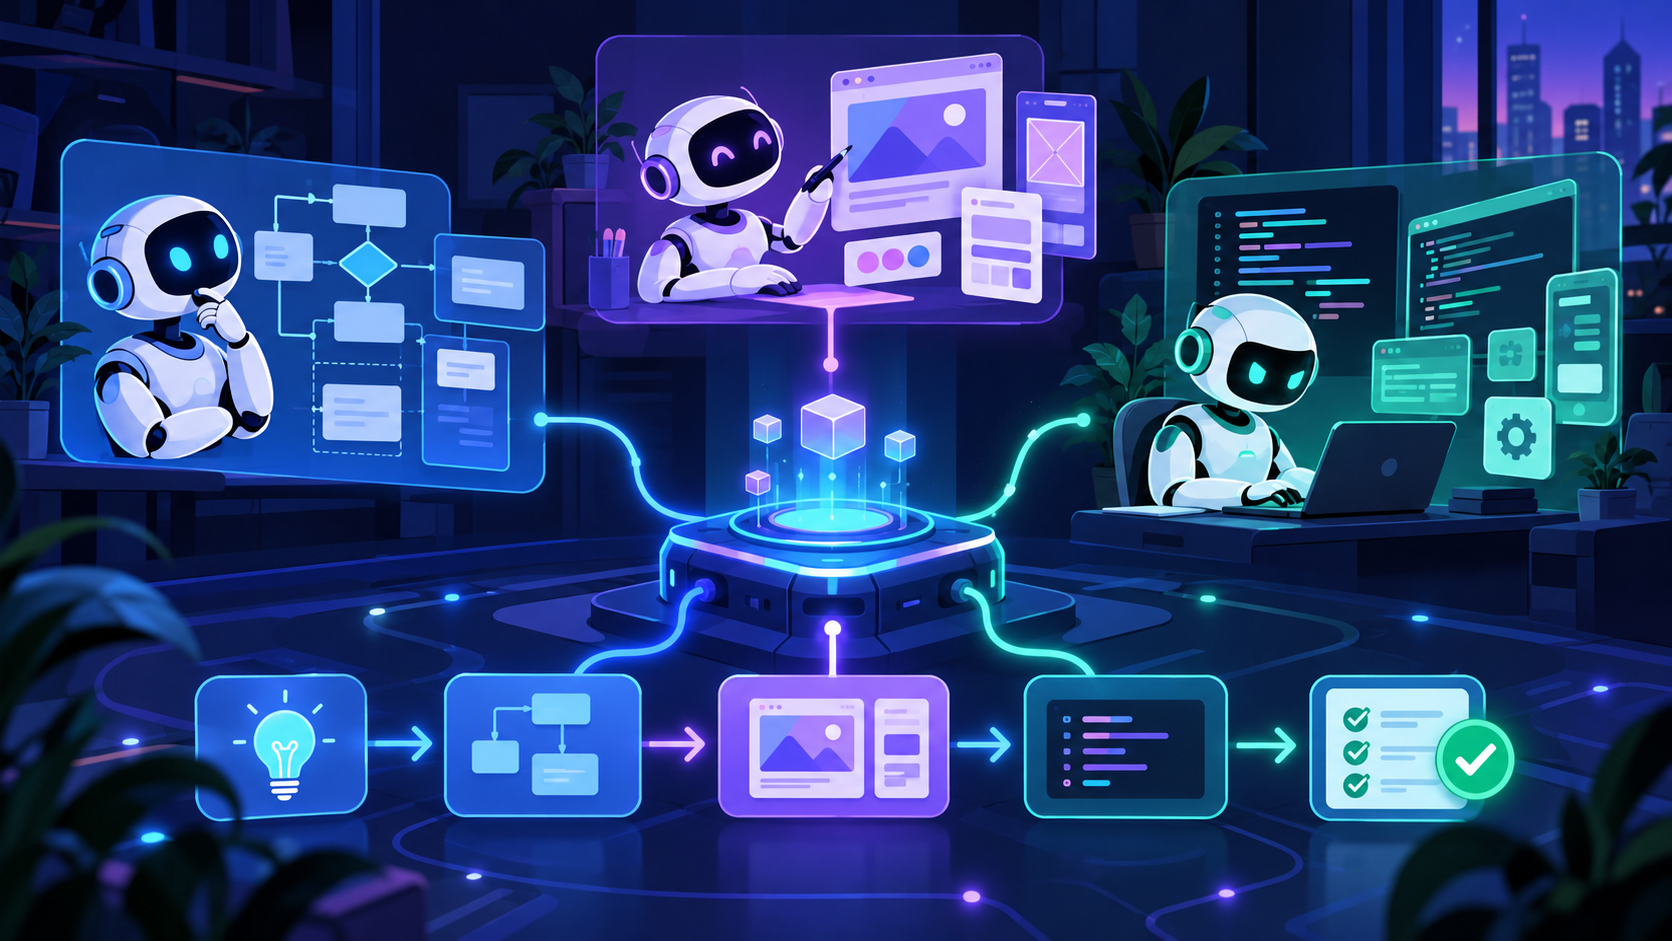
与其在一个聊天框里跟单个模型死磕,不如直接模拟真实的研发团队,给它们来一套明确的分工:
| 角色 | 模型 | 核心职责 |
|---|---|---|
| Planner(架构师) | GPT | 分析需求、技术选型、架构设计、拆分任务并冻结接口契约 |
| UI Designer(前端设计) | Gemini | 页面布局、样式细节、交互表现和前端 UI 组件实现 |
| Coder(程序员) | GLM | 业务逻辑、接口集成、WebGIS 核心功能、测试与 Bug 修复 |
| Reviewer(审查员) | GPT | 对照原始需求审查 Git diff 与测试证据,决定是否放行 |
这里并不是在评判哪个模型“绝对更强”,而是结合我自己的日常开发习惯给它们划分边界。模型本身随时可以替换,真正重要的是把职责、交付物和验收标准固定下来,让 AI 替你打工。
什么是 Multi-Agent 协同?它和“切模型聊天”有什么不同? 🤔
很多时候我们以为自己在用多模型,其实只是在“手动切窗口”。在真正动手配置之前,得先理清一个核心概念:
Agent(智能体)不只是一个模型名字。
一个完整的 Agent = 底层模型 + 角色指令(Prompt)+ 可用工具(Tools)+ 工作上下文 + 明确的交付目标。哪怕 Planner 和 Reviewer 底层用的都是 GPT,它们拿到的系统指令、任务边界和评判标准也完全不同。
所谓的 Multi-Agent 协同(多智能体协作),就是把一个大需求拆成多个职责明确的子任务,交给不同的 Agent 分头执行,再通过约定好的交付文档、共享状态和验收机制把结果拼合起来:
- 单 Agent 模式:一个助手从方案写到代码,最后自己宣布“完美搞定”。上手最简单,但上下文一长,职责和代码逻辑极易混成一团。
- 手动切换模型:在网页或 IDE 里先问 GPT 拿方案,再复制给 Gemini 画页面,最后丢给 GLM 写逻辑。虽然用上了多个模型,但缺乏统一的任务板、状态记录和独立验收,全靠人肉传话,还算不上真正的协同工作流。
当然,多 Agent 也不是银弹,它有实实在在的成本:每个角色都要消耗上下文和 Token 额度;交接契约写不清楚,不同模型就会重复造轮子;如果让两个 Agent 同时去改同一个文件,还会直接引发代码覆盖冲突。
因此,我的落地思路很明确:先跑通串行闭环、把交付协议立住,再去解锁并行开发和自动化调度。
OMP 是什么?为什么选它做入口? 🛠️
这次我选用的终端调度入口是 OMP(全称 Oh My Pi):
- GitHub 仓库:can1357/oh-my-pi
- 官方网站:omp.sh
先看一眼官网对它的硬核介绍:
A coding agent with the IDE wired in.
An agentic harness with all you need built in, powered by a native Rust core, with every tool tuned against real sessions. Windows-native, skip the WSL.
和普通的网页聊天框不同,这类 Coding Agent 不只是动嘴告诉你“代码该怎么写”,而是在获得授权后,能直接读取项目仓库、理解上下文、调用 LSP 与命令行工具、修改代码并跑完测试。
你可以把它简单理解为:大模型负责大脑推理,而 OMP 负责给 AI 装上“手和眼”,把模型的决策直接连进真实的本地开发环境。
对于习惯了终端和 Git 的开发者来说,用 OMP 最大的一个爽点在于:不用自己从零手搓一整套文件读写、代码 Diff 和命令执行框架,而且 Windows 原生支持(直接告别 WSL 折腾)。我们可以把全部精力放在最核心的事情上——怎么分派活儿、怎么定交接契约、怎么严格验收。
⚠️ 避坑提醒:需要注意,OMP 本身提供的是强大的工具底座与子 Agent(Subagent)发现与派发机制,要让多模型按照我们设定的研发流程乖乖配合,关键在于我们如何编写
AGENTS.md总控协议与子代理定义文件。下面我们就一步步把这套多模型流水线搭起来。
整体架构设计 🏗️
在我的方案里,以 Oh My Pi(OMP) 作为终端入口,保留主 Agent 作为调度中心(Dispatcher),由它根据任务性质分发给底层的四个专职子 Agent:
         用户提出需求
              │
              ▼
      OMP 主 Agent / 调度器
              │
              ▼
        GPT · Planner
        输出 plan.md
              │
    ┌─────────┴─────────┐
    │ 是否涉及 UI?      │
    └───────┬───────────┘
       是   │   否
       ▼    │
 Gemini · UI│
 输出组件和  │
 ui-spec.md │
       └────┼────────────┐
            ▼            │
        GLM · Coder ◀─────┘
        修改代码、运行测试
              │
              ▼
        GPT · Reviewer
       审查 diff 与测试证据
              │
   ┌──────────┴───────────┐
   ▼                      ▼
  PASS               CHANGES_REQUESTED
   │                      │
下一个任务         按责任退回 Gemini / GLM
                          │
                      重新验收
在这个架构里,有两个我刻意设计的工程约束:
- 真实 UI 组件与业务集成保持先后边界:Gemini 负责视觉与组件骨架,GLM 负责业务逻辑与状态接入。如果涉及同一个
.vue或.tsx组件文件,绝不允许两个 Agent 同时动手,避免互相覆盖代码。 - GPT 规划与 GPT 验收拆成两个独立会话:虽然 Planner 和 Reviewer 背后都是 GPT,但 Reviewer 启动时拥有独立的上下文,必须重新对照原始需求、实际 Git Diff 和命令行测试证据来挑刺,绝不能因为 Coder 自己汇报一句“我改好了”就直接放行。
认识 Agent Markdown 角色文件 📄
在 OMP 中,每个子 Agent 其实就是一个 Markdown 文件,结构非常直观:
---
name: fast-worker
description: 查找文件、按明确要求修改、运行命令并汇总输出。
model: Gemini
---

只完成分配的任务,不扩大范围。
返回修改文件和实际验证结果。
它由头部的 YAML Frontmatter 和下方的 Markdown 正文指令 两部分组成:
name:主线程调度时呼叫的代理名称。description:告诉主线程这个 Agent 擅长干什么活。model:指定使用的模型选择器或角色别名(比如@plan、@ui)。- 正文区域:严格约定它的职责边界、允许修改的文件范围、交付物路径以及验证要求。
💡 小贴士:光把
.md文件存下来并不会自动跑起模型,主线程需要通过 OMP 的task工具来按需唤醒它们;同时model字段也不能随便填个模糊的gpt或glm,需要配合后面的modelRoles做好路由映射。
根据 OMP 代理发现文档,OMP 原生支持用户级(全局)和项目级两种代理定义方式:
- 用户级(全局生效,推荐):放在
~/.omp/agent/agents/ - 项目级(仅当前仓库生效):放在
.omp/agents/(同名代理以项目级优先)
为了省去每个项目重复配置的麻烦,我直接采用了全局配置方案:
~/.omp/agent/
├── config.yml          # 全局配置文件(模型映射、并发设置等)
├── AGENTS.md           # 主线程总控协作规则
└── agents/             # 四个专职子 Agent 定义
    ├── planner-gpt.md
    ├── ui-gemini.md
    ├── coder-glm.md
└── reviewer-gpt.md这里要分清:AGENTS.md 是给主线程(包工头)看的调度总则,而 agents/ 目录下的四个文件是给具体干活的打工人看的岗位说明书。如果你原本就有全局 AGENTS.md,把协作规则合并进去即可。
如果你只想在某一个特定项目里试水,也可以采用项目级目录结构:
项目根目录/
├── AGENTS.md
├── START_PROMPT.md
└── .omp/
    ├── config.yml
    └── agents/
        ├── planner-gpt.md
        ├── ui-gemini.md
        ├── coder-glm.md
        └── reviewer-gpt.md
其中项目根目录的 AGENTS.md 用来放当前项目的技术栈约束(比如 Cesium 版本、代码规范),START_PROMPT.md 则是我们准备发给主线程的启动提示词。把角色映射集中在 config.yml 维护后,以后哪家出了新模型,改一行配置就能无缝切换,完全不用去批量改 Agent 文件。
一、实操搭建:从零配好三模型协同流水线 🛠️
1. 安装 OMP 📦
安装过程极其简单,OMP 官网提供了多种一键安装脚本。我平时比较喜欢用 bun,这里直接以 bun 为例:
bun install -g @oh-my-pi/pi-coding-agent安装完成后,在终端输入 omp 即可直接启动:
2. 登录对应的模型 Plan 🔑
在终端依次执行登录命令,绑定你手头的模型订阅通道:
omp login openai-codex
omp login google-antigravity
omp login zhipu-coding-plan
注:以上是我自己目前在用的三个订阅通道,大家根据自己实际的 API 或订阅提供商调整即可。
3. 配置模型角色映射(config.yml) ⚙️
为了解耦,我没有在每个 Agent 文件里写死冗长的模型 ID,而是统一使用 @plan、@ui、@code、@review 四个角色别名,再把具体映射集中写进全局 ~/.omp/agent/config.yml:
modelRoles:
  default: openai-codex/gpt-6.1-sol
  plan: openai-codex/gpt-6.1-sol
  review: openai-codex/gpt-6.1-sol
  ui: google-antigravity/gemini-3.8-flash:high
  code: zhipu-coding-plan/glm-5.3

retry:
  modelFallback: false

prewalk:
  enabled: false

advisor:
  enabled: false

async:
  enabled: true

task:
  maxConcurrency: 10
  batch: true
  prewalk: false
  agentModelOverrides:
    planner-gpt: '@plan'
    ui-gemini: '@ui'
    coder-glm: '@code'
    reviewer-gpt: '@review'
  agentPrewalk:
    planner-gpt: 'off'
    ui-gemini: 'off'
    coder-glm: 'off'
    reviewer-gpt: 'off'
  agentAdvisor:
    planner-gpt: 'off'
    ui-gemini: 'off'
    coder-glm: 'off'
    reviewer-gpt: 'off'
  isolation:
    enabled: false
这几个开关背后都有明确的工程考量:
modelFallback: false:故意关掉自动降级回退。一旦某个角色调用失败,直接报错提醒我,防止它悄悄切到别的模型“冒名顶替”。prewalk: false:避免 Agent 在准备写文件前又被切到其他模型。advisor: false:我们已经专门配了独立的reviewer-gpt做结果把关,不需要每轮对话都额外挂一个 Advisor 消耗 Token。task.agentModelOverrides:它的优先级高于 Agent Markdown 文件里的model字段,排查模型路由不对时记得两处一起看(更多细节可参考 OMP 设置文档)。
保存配置后,可以用下面这几条命令做个快速核对:
omp config get modelRoles
omp config get task.agentModelOverrides
omp config get task.maxConcurrency
omp config get task.batch
omp config get async.enabled
⚠️ 避坑重点:我在当前版本里试过直接跑
omp config set modelRoles.code ...,终端会报Unknown setting。最稳妥的做法是直接打开config.yml编辑modelRoles节点,改完后再用omp config get modelRoles读出来确认,千万别以为命令敲完就一定生效了。
4. 编写四个子 Agent 定义文件 🧠
下面是我实战打磨后的精简版角色定义。在 ~/.omp/agent/agents/ 目录下分别创建对应的 .md 文件,确保文件名与 YAML 里的 name 完全一致。
① Planner(GPT):把模糊需求拆成冻结契约
保存为 agents/planner-gpt.md:
---
name: planner-gpt
description: 读取仓库,制定方案、任务依赖、接口契约和验收标准。
model: '@plan'
tools: [read, grep, glob, bash, edit, write]
blocking: true
---

你负责方案规划,不实现业务代码,不继续委派。
先阅读原始需求、项目规则、相关代码和已有修改。
不凭空假定框架、版本或项目目录。

写入 .agent-work/plan.md:

- 需求范围、必要假设和技术方案。
- 并行前冻结的 props、事件、模块导出和数据结构。
- 任务依赖、独占文件范围和验收条件。

初次创建 task-board.md 草案,后续由主线程维护状态。
只修改规划文档,不能覆盖用户原有代码。
返回文档路径、任务顺序、可并行任务组和阻塞事项。
很多时候 AI 写代码翻车,是因为需求太宽泛。比如在 WebGIS 项目里只说一句“新增材质编辑面板”,AI 肯定自由发挥。Planner 的核心任务就是在写代码前先把材质字段、选中要素 ID、事件 Payload、GLM 要接的方法名以及验证手段全部定死。
② UI Designer(Gemini):交付真实可用的组件与样式
保存为 agents/ui-gemini.md:
---
name: ui-gemini
description: 负责页面、展示组件、样式和 UI 交接契约。
model: '@ui'
tools: [read, grep, glob, bash, edit, write, lsp]
blocking: false
---

只实现当前任务分配的 UI 文件,不继续委派。
沿用现有技术栈和设计语言,不擅自安装 UI 库。
按 Planner 冻结的 props、事件和数据契约实现。
把组件契约写入 .agent-work/ui-spec/<任务ID>.md。
只写自身任务的报告,不修改共享任务板或契约汇总。
不进行截图验证,不要求执行 npm run build。
返回修改文件、接口约定、实际检查和未验证项。
这里给 Gemini 立了规矩:只给口头设计建议不算完,必须落地成真实的组件文件,并且把 props 类型、事件载荷、loading/empty/error 状态以及留给业务逻辑的占位区清晰写进 .agent-work/ui-spec/<任务ID>.md,方便后面的 GLM 直接照单接线。(比如在 Vue 项目里,我习惯要求非必要统一用 <style scoped lang="scss">,这类个人偏好也可以按项目写进规则里。)
③ Coder(GLM):实现业务模块与 WebGIS 集成
保存为 agents/coder-glm.md:
---
name: coder-glm
description: 负责业务逻辑、状态管理、API、集成和必要测试。
model: '@code'
tools: [read, grep, glob, bash, edit, write, lsp]
blocking: false
---

只实现当前任务和允许修改的文件,不继续委派。
独立业务模块按冻结契约开发,不等待 UI 完成。
修改真实 UI 组件前,等待对应 UI 任务完成。
不私自重做界面,不覆盖其他任务的文件。
仅报告实际执行的验证,未运行标为 NOT_RUN。
在常规前端项目里,GLM 负责 service、store、权限校验和接口联调;到了 WebGIS 场景下,它就专门负责地图要素拾取(Picking)、选中对象状态同步、三维材质参数更新或渲染管线逻辑。
④ Reviewer(GPT):看证据说话的独立审查员
保存为 agents/reviewer-gpt.md:
---
name: reviewer-gpt
description: 独立检查需求覆盖、代码差异、接口集成和真实验证结果。
model: '@review'
tools: [read, grep, glob, bash, edit, write]
blocking: true
---

你负责验收,不修改实现代码,不继续委派。
先读原始需求,再检查计划、验收项、实际代码和验证记录。
区分用户原有修改与本轮代理修改。
报告工具只用于自身审查文件,不直接修复源码。

每项检查标记 PASS / FAIL / NOT_RUN。
总结果使用:

- PASS:关键验收项有充分证据通过。
- CHANGES_REQUESTED:存在具体可修复问题。
- BLOCKED:关键判断缺少环境、权限或证据。

问题写明文件位置或复现步骤、影响、预期修复和 Owner。
写入 .agent-work/reviews/<任务ID>-r<轮次>.md。
没有运行证据就说明未验证,不把旧检查结果当作新代码通过。
💡 为什么拆出独立 Reviewer?
让写代码的同一个上下文自己检查自己,它往往会“睁一只眼闭一只眼”。单开一个会话跑reviewer-gpt,强制它核对 Git Diff 和命令输出,能大幅减少“假装修好”的情况。同时要注意,工具列表里的write只是为了写审查报告,权限层并不能物理锁死它改源码,所以依然要靠审查报告和 Diff 双重把关。
5. 配置主线程总控协议(AGENTS.md) 📋
四个打工人就位后,还要给主线程立一套“项目经理手册”(写入 ~/.omp/agent/AGENTS.md)。核心原则就一条:用结构化文档交接,绝不让多个 Agent 争抢修改同一个文件。
我们在项目下约定一个 .agent-work/ 工作目录,结构如下:
.agent-work/
├── plan.md                      # Planner 输出的方案与冻结契约
├── task-board.md                # 主线程统一维护的任务状态板
├── ui-spec.md                   # 主线程汇总的 UI 契约
├── ui-spec/
│   ├── T01.md                   # 每个 UI 任务独立的接口契约
│   └── T02.md
├── results/
│   ├── T01-ui-gemini-r0.md      # 各子 Agent 独立的执行结果报告
│   └── T02-coder-glm-r0.md
├── reviews/
│   └── T01-r0.md                # Reviewer 每轮独立的审查报告
└── review.md                    # 主线程汇总的最终验收结论
以 WebGIS 里常见的“选中对象材质编辑面板”为例,主线程维护的 task-board.md 会拆成这样:
| 任务 ID | 工作内容 | 负责人(Owner) | 前置依赖 | 独占修改范围 |
|---|---|---|---|---|
| T01 | 编辑面板 UI 组件实现 | ui-gemini |
已冻结的数据契约 | 展示组件与样式文件 |
| T02 | 选中对象状态管理模块 | coder-glm |
同一套数据契约 | Store 与类型定义文件 |
| T03 | 面板与地图拾取事件联调集成 | coder-glm |
T01、T02 均完成 | 业务集成层代码 |
| T04 | 需求覆盖度与回归验收 | reviewer-gpt |
T03 完成 | 独立验收报告 |
可以看到,只要提前把类型定义和接口契约冻结好,T01(画页面)和 T02(写状态)天生就能并行推进,等它们双双完工,再交由 T03 合拢集成。
任务状态统一使用 TODO / DOING / DONE / BLOCKED:子 Agent 干完活只能先汇报,必须等 Reviewer 给出 PASS 后,才由主线程把状态改成 DONE。如果同一个问题连续返工两轮还没进展,主线程就会触发熔断保护,避免死循环空耗 Token。
二、首轮实战测试:先跑通四角色串行闭环 🧪
配置写完后,先在 OMP 里输入 /agents 看看四个子代理有没有被成功识别:
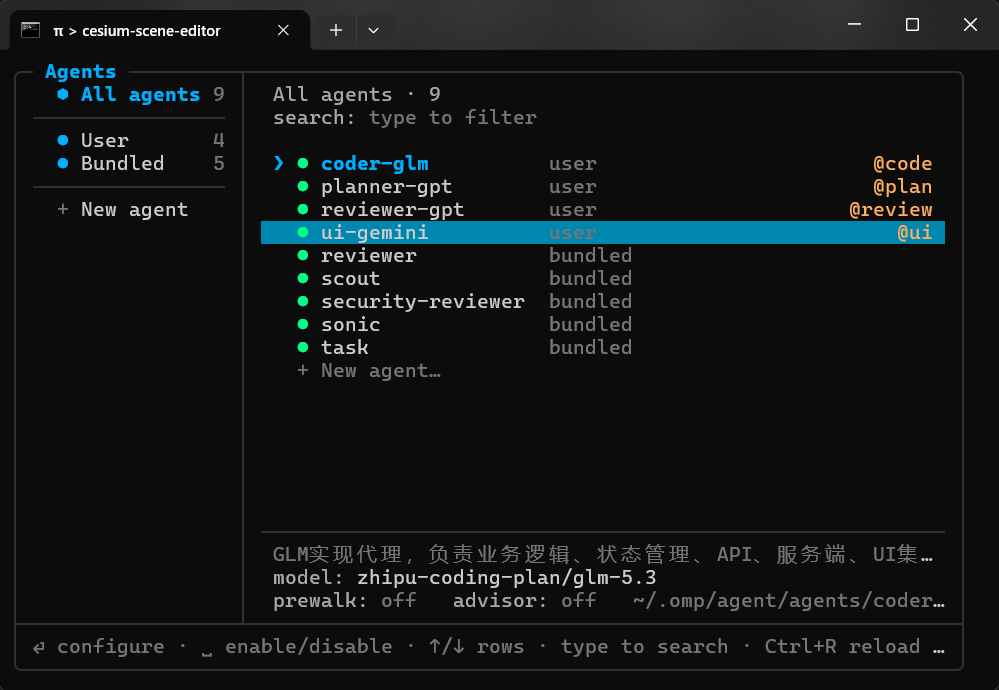
确认无误后,我们先找个空目录,发一段测试 Prompt 验证四个角色能不能按规矩接力干活:
测试全局多模型协作配置。真实调用四个指定子代理,串行执行,不得用主线程模拟角色。

在当前空目录制作一个设置页面:
- 使用原生 HTML/CSS/JavaScript,不安装依赖。
- 包含浅色/深色主题选择和保存按钮。
- 保存到 localStorage,刷新后恢复。
- 只修改当前目录,不提交或部署。

分工:
1. planner-gpt:制定精简方案和验收标准。
2. ui-gemini:实现页面布局、样式和控件,说明 DOM 接口。
3. coder-glm:接入主题切换、保存和恢复逻辑。
4. reviewer-gpt:检查实际文件、执行可用检查,逐项验收。

保留各阶段报告。不执行构建,不进行截图验证。
没有实际验证的浏览器行为标记 NOT_RUN,不能假称通过。
代理调用失败时报告具体错误,不换模型。
发送后,可以看到主线程已经开始按顺序唤醒对应的子 Agent 了:
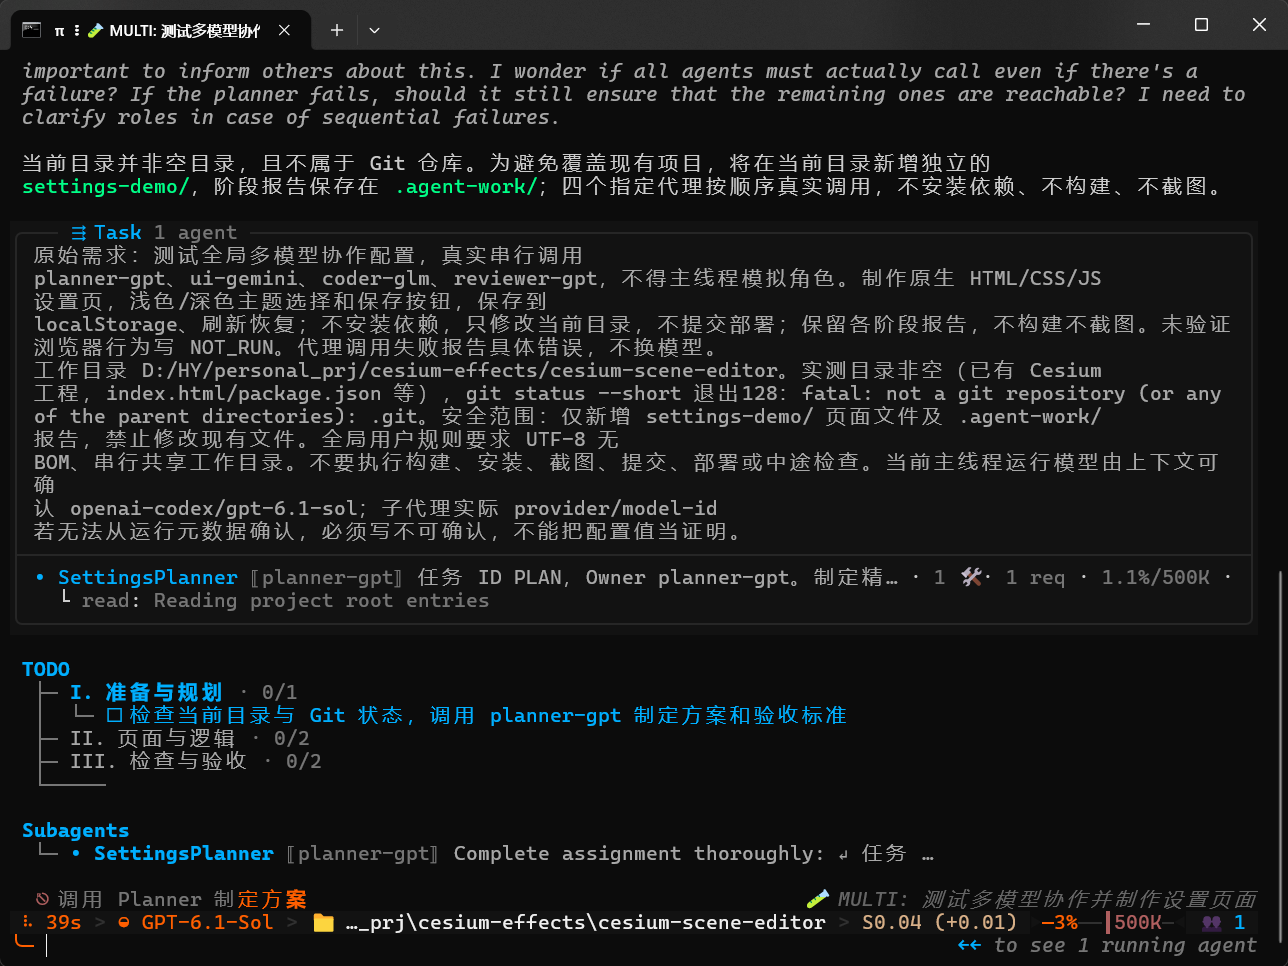
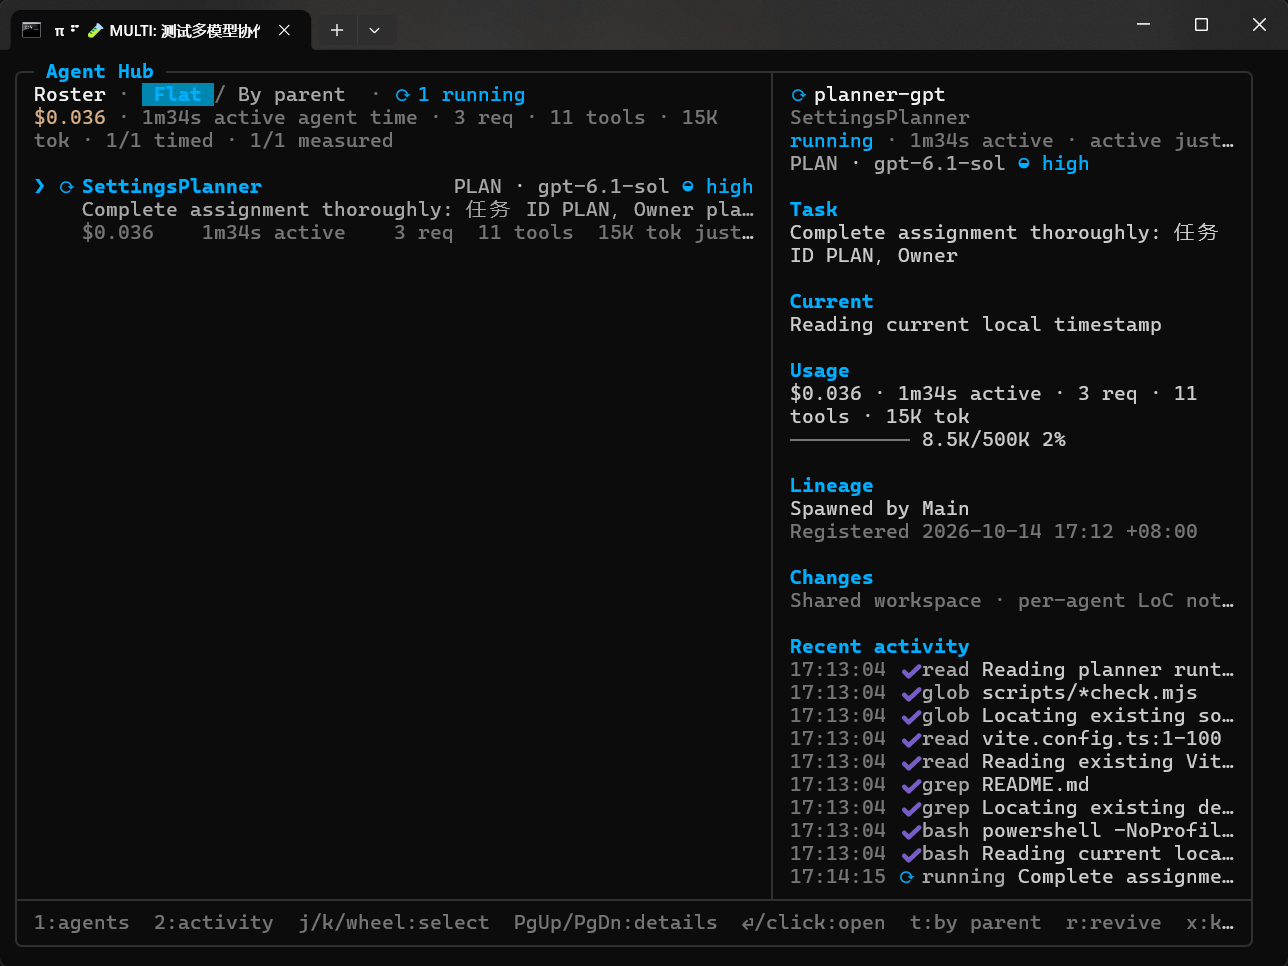
这时候连按两下左方向键 ←←(或快捷键打开 Agent Hub),就能实时围观各个子 Agent 的工作状态和调用详情:
三、效率进阶:如何让 UI 与业务 Agent 真正并行开发? ⚡
上面的测试虽然跑通了流程,但本质上还是“接力赛”——上一个 Agent 干完,下一个才开工。
在真实的开发团队里,只要前后端或组件接口定好了,UI 和底层业务模块完全可以同时写。接下来我们就用五步改造,把多 Agent 并行开发真正压榨出来!
第一步:开启异步、批量派发与并发容量
在终端执行以下三条配置命令:
omp config set task.maxConcurrency 10
omp config set task.batch true
omp config set async.enabled true
这三个参数各司其职,缺一不可:
| 配置项 | 实际作用 | 常见误区说明 |
|---|---|---|
task.maxConcurrency: 10 |
当前会话最多允许 10 个子 Agent 同时运行 | 不是每次都会拉起 10 个,也不是多开终端共享的总额 |
task.batch: true |
允许单次 task 工具调用里传入多个子任务 |
不会自动把你分多次发送的任务合并,需主线程打包派发 |
async.enabled: true |
允许非阻塞 Agent 在后台跑,释放主线程继续调度 | 不会无视前置依赖,有依赖关系的任务仍需按序等待 |
对应到全局 ~/.omp/agent/config.yml 里,就是下面这两段(如果配置文件里已经有同名顶层键,直接合并进去,别重复写):
async:
  enabled: true

task:
  maxConcurrency: 10
  batch: true
第二步:将实现类 Agent 改为非阻塞(blocking: false)
分别打开 ~/.omp/agent/agents/ui-gemini.md 和 ~/.omp/agent/agents/coder-glm.md,把头部 YAML Frontmatter 里的 blocking 设为 false:
blocking: false注意:blocking: false 必须写在两条 --- 之间的 YAML 头里,写在正文里当普通文字是无效的。
调整后,四个角色的阻塞策略分工如下:
| 子 Agent | blocking |
调度逻辑说明 |
|---|---|---|
planner-gpt |
true |
必须阻塞:等方案和接口契约彻底冻结后,才允许放行后续开发 |
ui-gemini |
false |
非阻塞后台运行:可与互不依赖的业务模块同时开工 |
coder-glm |
false |
非阻塞后台运行:支持同时拉起多个实例,分头写不同的业务文件 |
reviewer-gpt |
true |
必须阻塞:等待所有实现落盘并完成审查,决定最终 PASS 还是打回 |
第三步:更新主线程 AGENTS.md 的并行调度规则
打开 ~/.omp/agent/AGENTS.md,把原先强制串行的规则改成按依赖关系与文件独占范围动态判断,加入以下并行调度协议:
## 并行调度

- Planner 先冻结接口契约,标出任务依赖和独占文件。
- 依赖已满足、修改文件不重叠的任务,在同一次 task 调用的 tasks 数组中批量派发。
- 每个实例使用唯一 name、任务 ID 和独立结果报告。
- 不要等待同一并行组的第一个任务完成后,才启动第二个。
- 同一个 coder-glm 可以创建多个实例,但不得修改同一文件。
- 主线程维护任务板;代理不得争写任务板和汇总报告。
- 依赖真实 UI 的集成任务,必须等待相关 UI 和业务任务完成。
- 最终验收必须等待被审查范围的实现结束。
- 异步返回仅表示已派发,必须收集真实完成结果。
第四步:让主线程在单次 tasks 数组中批量派发
开启批量模式后,主线程在调用 task 工具时,就可以在一个 tasks 数组里同时塞进多个互不冲突的子任务。比如当规划契约已经冻结时,派发结构长这样:
{
  "context": "在当前测试目录实现主题页面。计划已冻结:index.html 引用 styles.css 和 theme.js;storage.js 导出 readTheme()、saveTheme(theme)。只修改各任务独占文件,报告写入指定路径,不修改共享任务板。",
  "tasks": [
    {
      "name": "ThemeUi",
      "agent": "ui-gemini",
      "task": "任务 P1:仅创建 index.html、styles.css 和 .agent-work/results/P1-ui.md。实现主题选择页面,按钮 ID 为 light-btn、dark-btn、save-btn,状态文本 ID 为 status。不要实现业务 JavaScript。",
      "solutionSpace": "DOM接口和文件范围固定,布局与样式由代理设计。"
    },
    {
      "name": "ThemeStorage",
      "agent": "coder-glm",
      "task": "任务 P2:仅创建 storage.js 和 .agent-work/results/P2-storage.md。使用 localStorage 键 omp-parallel-theme。readTheme返回light或dark,缺失或非法值回退light;saveTheme返回保存是否成功,存储异常不向外抛出。不要等待页面完成。",
      "solutionSpace": "接口、数据取值和错误约定固定,按契约实现存储模块。"
    }
  ]
}
💡 关键点:上面这段 JSON 是主线程内部调用
task工具的参数结构示意。日常使用时,我们只需要在 Prompt 里明确要求主线程**“用同一次 task 调用的 tasks 数组同时启动”**,防止它习惯性地调完一个等结果、再调下一个。
第五步:核对配置并开新会话验证
最后在终端检查一遍三个核心开关:
omp config get task.maxConcurrency
omp config get task.batch
omp config get async.enabled
确认依次输出 10、true、true 后,为了防止旧会话的上下文记忆干扰,我们在空目录里重新启动一个干净的 OMP 会话来做并行测试。
四、并行实战验证:一个 Gemini + 两个 GLM 同时开工 🔥
我们还是拿经典的“主题设置页面”做实验,但这次把 UI 页面(index.html + styles.css)、本地存储模块(storage.js) 和 交互控制模块(theme.js) 拆成三个完全独立的文件,看看能不能让 1 个 Gemini 实例 + 2 个 GLM 实例 同时开干!
在终端新建测试目录并启动 OMP:
New-Item -ItemType Directory -Path .\omp-parallel-test -Force
Set-Location .\omp-parallel-test
omp --model openai-codex/gpt-6.1-sol
直接把下面这段提示词丢给主线程:
做一次真实并行代理测试,只修改当前空目录。
不安装依赖,不提交、不部署、不构建、不截图。

先调用 planner-gpt,冻结以下契约:
- 原生 HTML/CSS/JavaScript 主题设置页面。
- index.html 引用 styles.css 和模块脚本 theme.js。
- 按钮 ID 为 light-btn、dark-btn、save-btn,状态文本 ID 为 status。
- 当前主题在 document.documentElement.dataset.theme,值为 light 或 dark。
- storage.js 导出 readTheme()、saveTheme(theme)。
- localStorage 键为 omp-parallel-theme。
- readTheme() 遇到缺失或非法值返回 light。
- saveTheme() 返回是否保存成功,存储异常不得向外抛出。
- theme.js 导入存储模块,实现主题切换、保存和刷新恢复。

规划后,用同一次 task 调用的 tasks 数组同时启动三个实例:
1. UiPage,agent=ui-gemini:只写 index.html、styles.css 和自身报告。
2. ThemeStorage,agent=coder-glm:只写 storage.js 和自身报告。
3. ThemeInteraction,agent=coder-glm:只写 theme.js 和自身报告。

三个任务按冻结契约独立开发,不等待其他实现任务结束。
每个实例使用不同名称、任务 ID 和结果文件。
主线程不得替代理编写上述实现文件。

收集三个任务的实际完成结果后,再调用 reviewer-gpt 验收。
没有浏览器运行证据时,交互检查标记 NOT_RUN。
调用失败明确报告,不切换模型,不冒充其他代理。
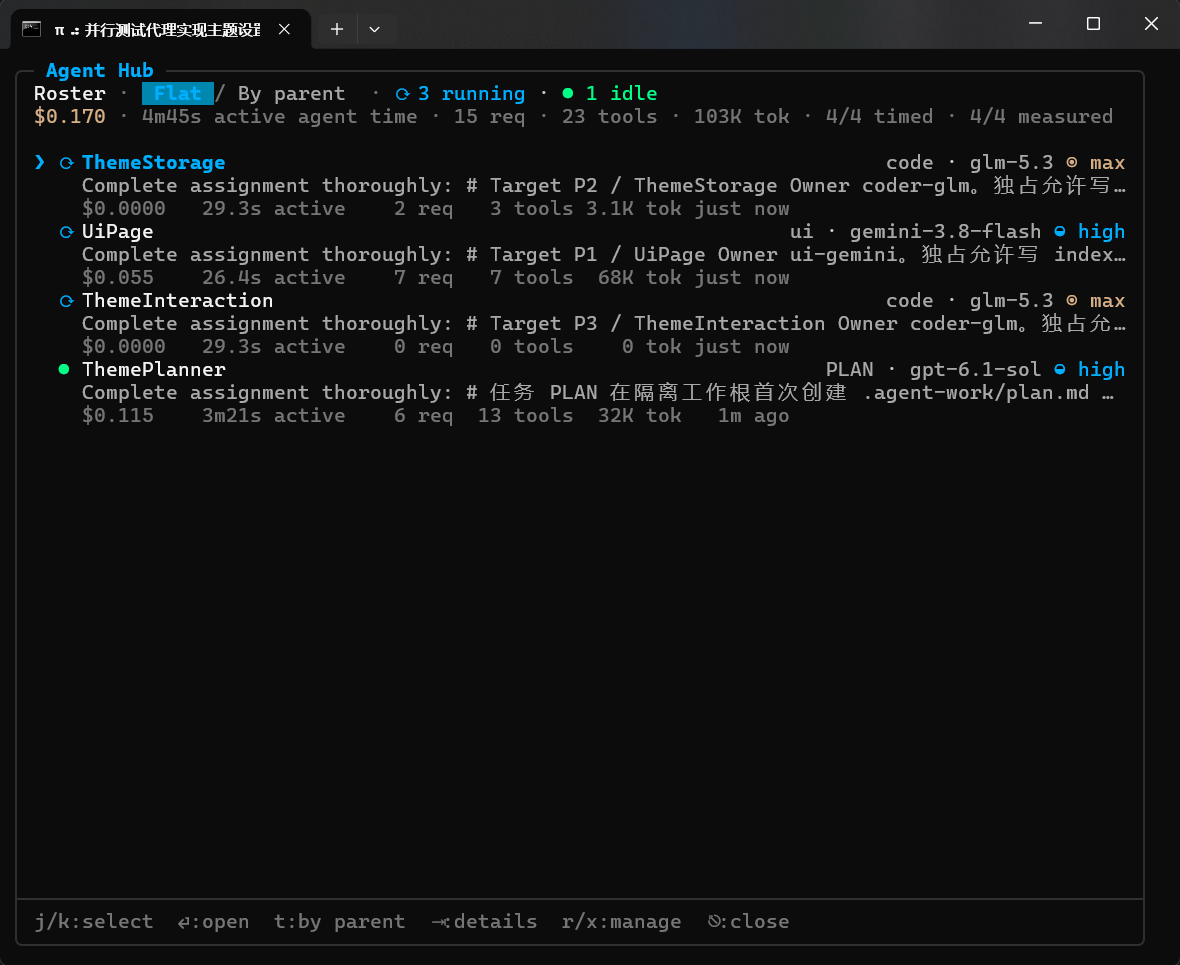
怎样确认它们是真的在“并行”?
任务派发后,立刻按 ←← 打开 Agent Hub 面板,核对正在运行的实例名称与底层模型:
| 实例名称 | 负责模块 | 实际运行模型 |
|---|---|---|
UiPage |
页面结构与 CSS 样式 | Gemini 3.8 Flash |
ThemeStorage |
localStorage 读写封装 |
GLM-5.3 |
ThemeInteraction |
DOM 事件绑定与状态同步 | GLM-5.3 |
只要在 Agent Hub 里看到至少两个实例同时处于 Running 状态,或者它们的时间戳存在明显重叠,就说明真正的并行开发已经跑起来了:
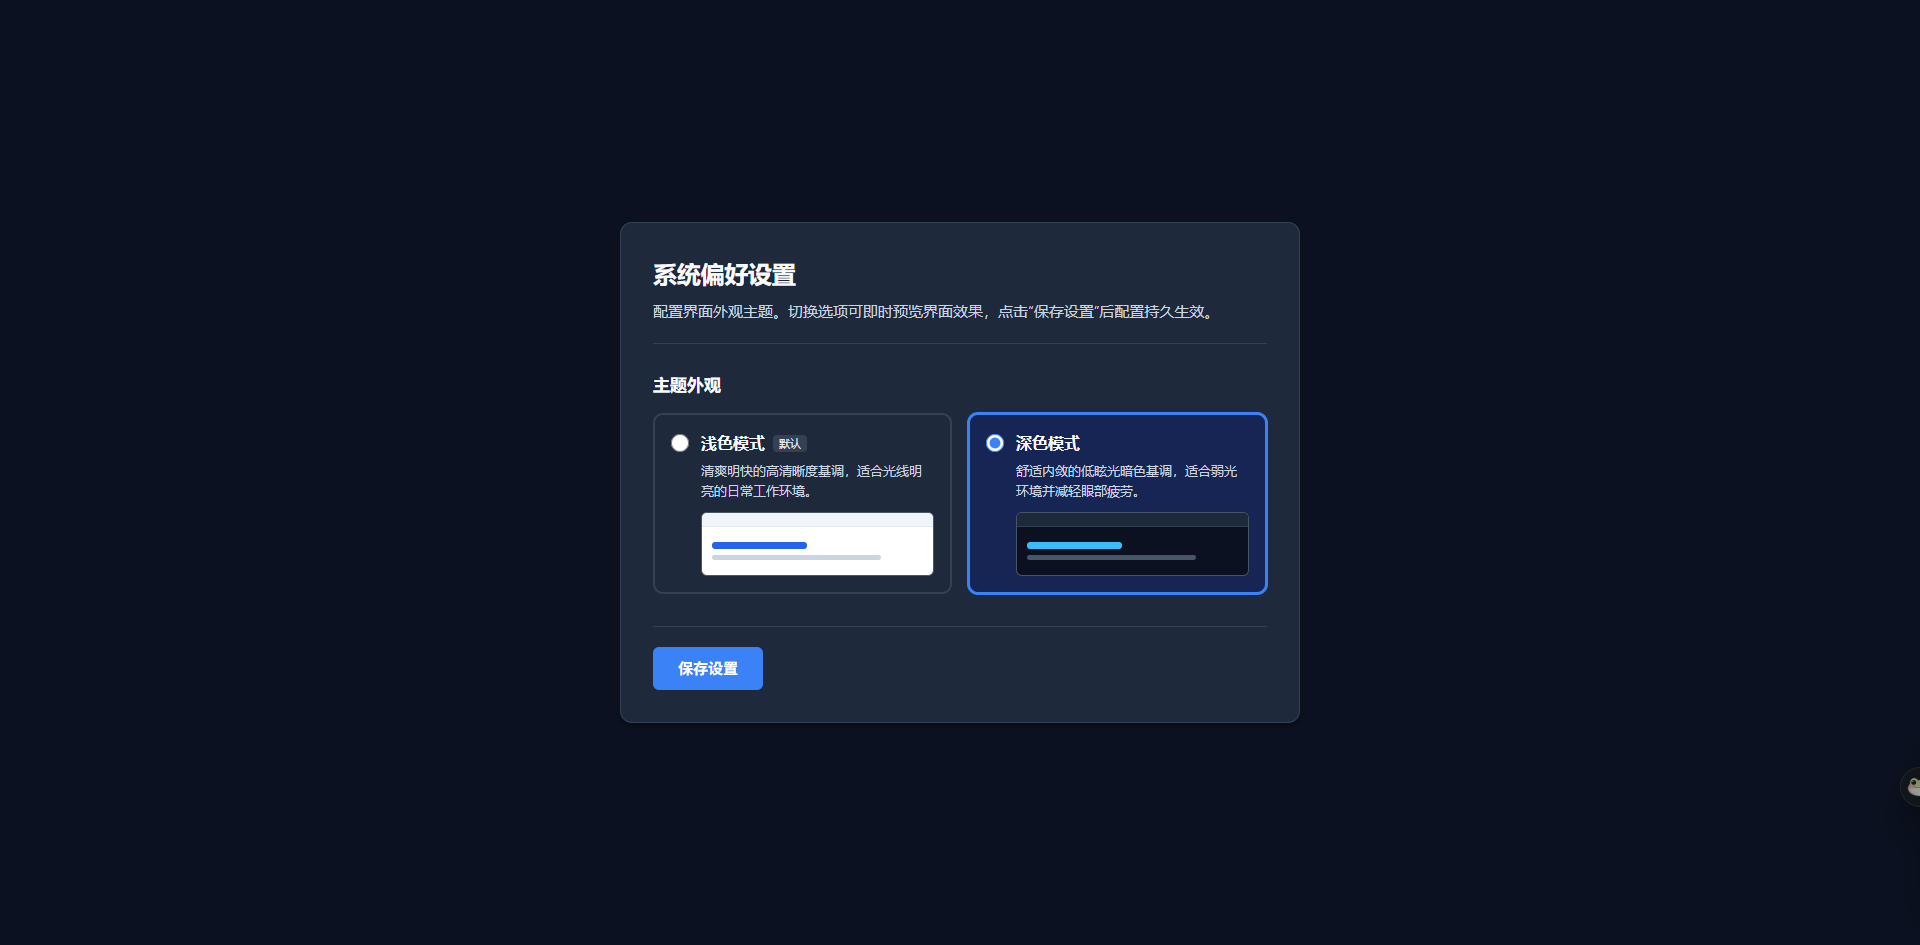
等三个实现实例全部返回结果、并由 reviewer-gpt 审查通过后,打开生成的页面看看最终成果,深浅主题切换与本地持久化一次跑通,体验相当丝滑:
一些个人感受 🌟
AI 时代的技术迭代实在太快了。其实上面折腾的这一整套配置文件、角色定义和调度规则,完全可以反过来直接丢给 AI 一句话自动配好,我们自己真正需要动手的,只剩下敲命令登录账号这种敏感操作,耗时已经快到让人有点恍惚
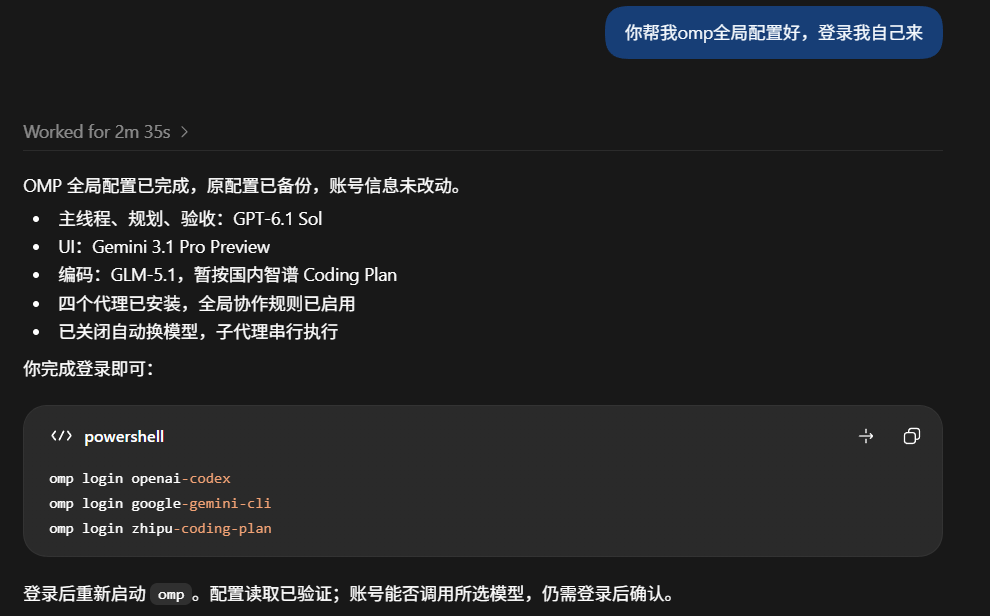
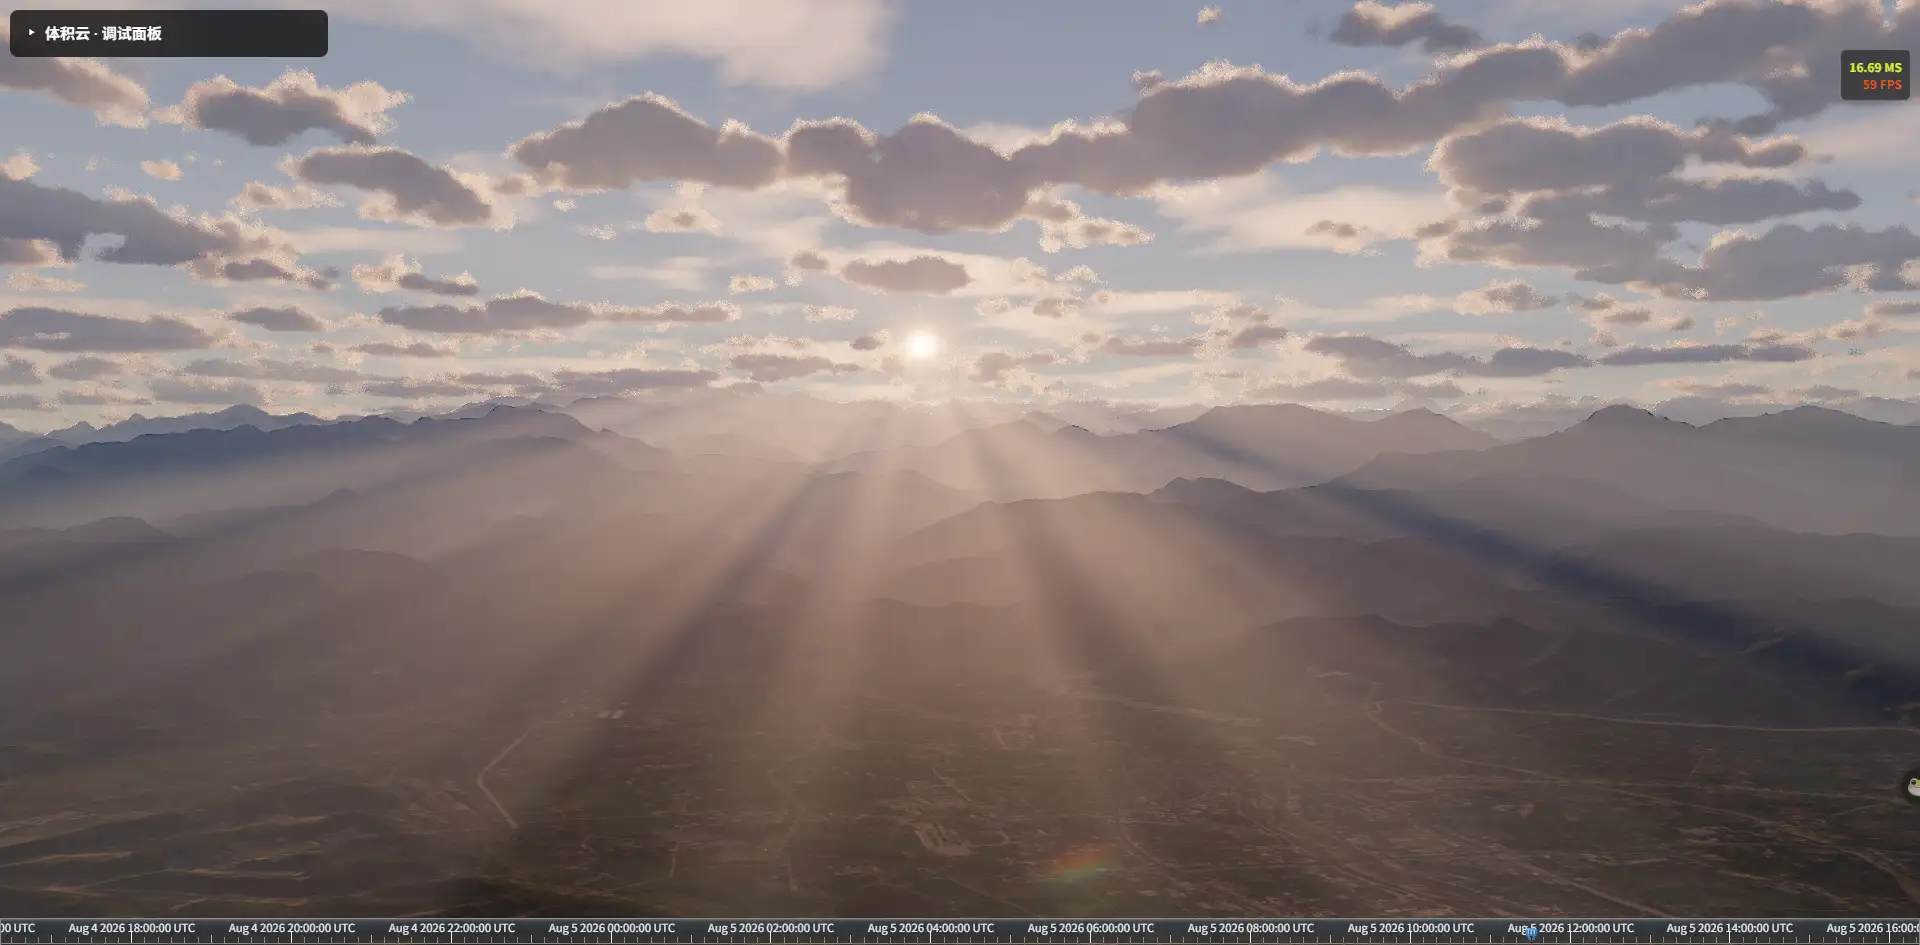
这和前段时间我用 AI 移植 Cesium 高质量体积云时的感受如出一辙:当写具体语法、查 API 甚至改几十个文件的成本被 AI 无限摊薄之后,开发者的核心价值反而回到了更本质的地方。
不管手头有几个顶尖模型、配了多么花哨的 Multi-Agent 流水线,真正决定项目能不能跑通的,依然是我们自己的工程判断:
提出真实且具体的需求 ➔ 让 AI 检索并给出架构方案 ➔ 人工审核方案与契约合理性 ➔ 放手让多 Agent 并行执行与交叉验收把重复的“手搓”和切窗口交给工具,把精力留给架构设计、边界划分与结果把关
.png)